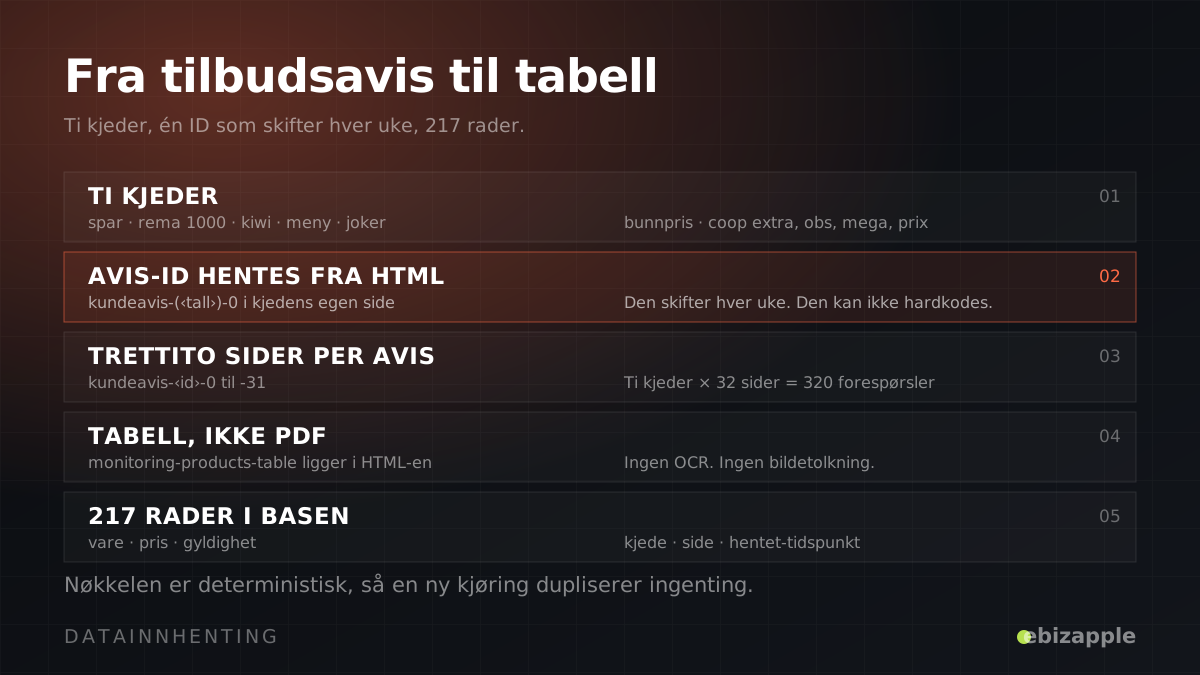
Vi hentet ti kjeders tilbudsaviser — uten å åpne én eneste PDF
Avis-ID-en skifter hver uke. Det er den ene detaljen som avgjør om automatiseringen lever eller dør på mandag.
middels
Les
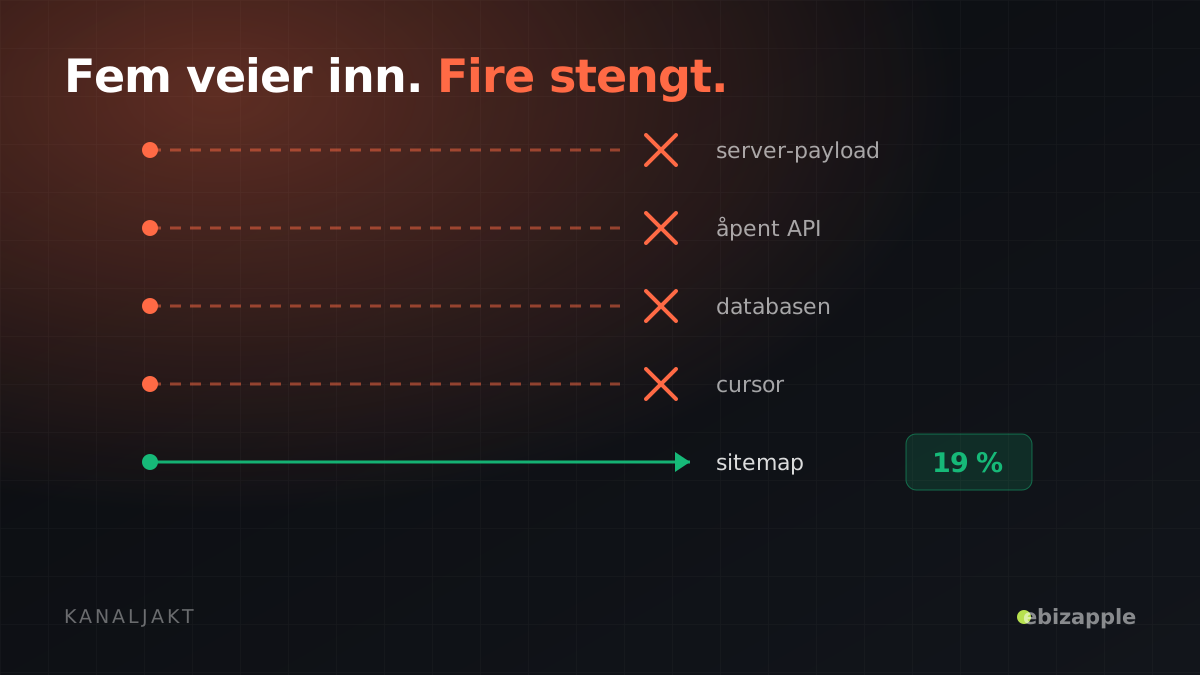
Vi kartla en norsk produktkatalog for å hente ut varedata. Fire av fem veier var blindveier. Her er hver eneste av dem — og de 19 % vi endte på.
En kunde ville vite hva konkurrentene hadde på lager. Ikke i går, ikke omtrent — daglig, og med pris.
Nettstedet vi skulle hente produktdata fra, så enkelt ut. Produktsider med pris, antall og status, pent strukturert. Vi regnet med en halv dag.
Det tok en uke, og vi kom aldri i mål med full dekning. Denne artikkelen er alle blindveiene, i den rekkefølgen vi gikk dem, fordi det er den delen ingen skriver om.
Kort vei til svaret: vil du bare vite om katalogen deres lar seg hente, be om en vurdering — vi ser på nettstedet og sier hva som er mulig. Vil du forstå veiene selv, les videre.
Denne artikkelen bygger på ett faktisk prosjekt, ikke på en litteraturgjennomgang. Vi kartla en produktkatalog for en betalende kunde sommeren 2026, og alle tallene under er målt under kjøring — 2 002 operasjoner, 5,6 minutter, 1 000 sider, 19 % dekning. De er lest av fra kjøringen, ikke anslått i etterkant.
Det er verdt å si hva dette ikke er:
Det vi kan stå inne for: hver blindvei under ble faktisk gått, i den rekkefølgen som står her, og hvert tall er hentet fra loggen til kjøringen som produserte det.
Teknikken på nettsteder endrer seg raskt — en sitemap kan utvides, et API kan åpnes. Artikkelen gjennomgås derfor på nytt når teknikken på nettstedet endrer seg. Sist gjennomgått 14. august 2026.
Skrevet av Svein Tore Olsen, daglig leder i Ebizapple.
Å hente produktdata automatisk ut av et nettsted heter web scraping på engelsk. Om scraping er lov i Norge, er spørsmålet norske bedrifter stiller først — og det er riktig å stille det først.
Kort svar: produktdata er ikke persondata. Priser, artikkelnumre og lagerstatus faller ikke inn under personopplysningsloven. Det som avgjør er tre andre ting:
Brukervilkårene på nettstedet. Mange nettsteder har brukervilkår som forbyr automatisert innhenting. De er ikke straffelov, men de er en avtale — og bryter du den, har motparten et sivilrettslig krav. Vi leste brukervilkårene før vi skrev en eneste linje kode, og vi leste robots.txt i samme slengen. Den filen er ingen lov, bare nettstedets egen beskjed om hvilke deler automatiske klienter bør holde seg unna. Men den er en skriftlig beskjed, og velger du å overse den, skal du kunne forklare hvorfor.
Databasevernet. Åndsverkloven verner sammenstillinger som har krevd en vesentlig investering. Det er databasevernet, ikke opphavsretten til den enkelte prisen, som er den relevante bestemmelsen her — og å hente noen priser er noe annet enn å kopiere hele katalogen og publisere den som din egen.
Belastningen. Å hamre en server med tusen forespørsler i minuttet er et problem uavhengig av jus. De fleste nettsteder av en viss størrelse har dessuten rate limiting — et tak på hvor mange forespørsler samme klient får sende i minuttet. Treffer du taket, får du ikke data, du får en feilkode, og gjentar du det, får du en sperre. Vi kjørte med pause mellom forespørslene og holdt oss til det en ivrig kunde kunne generert. Det er samme hensyn vi legger inn i all automatisering som snakker med systemer vi ikke eier selv: gå sakte nok til at den andre siden ikke merker deg.
Og det ryddigste alternativet, som vi anbefalte kunden vår først: spør om en offisiell datakanal. Mange leverandører har en partnerfeed de gladelig gir ut. Det er billigere enn all teknikken under, og det tåler dagslys.
Kunden ville ha et bilde av markedet uten å varsle konkurrenten. Greit nok. Da ble det teknisk.
Next.js med App Router, driftet på Vercel, med Supabase som database. Det er en helt vanlig moderne stakk i 2026, og den oppfører seg annerledes enn den gamle WordPress-verdenen — der innholdet som regel ligger ferdig i HTML-en, slik vi beskriver i gjennomgangen vår av WordPress-nettsider.
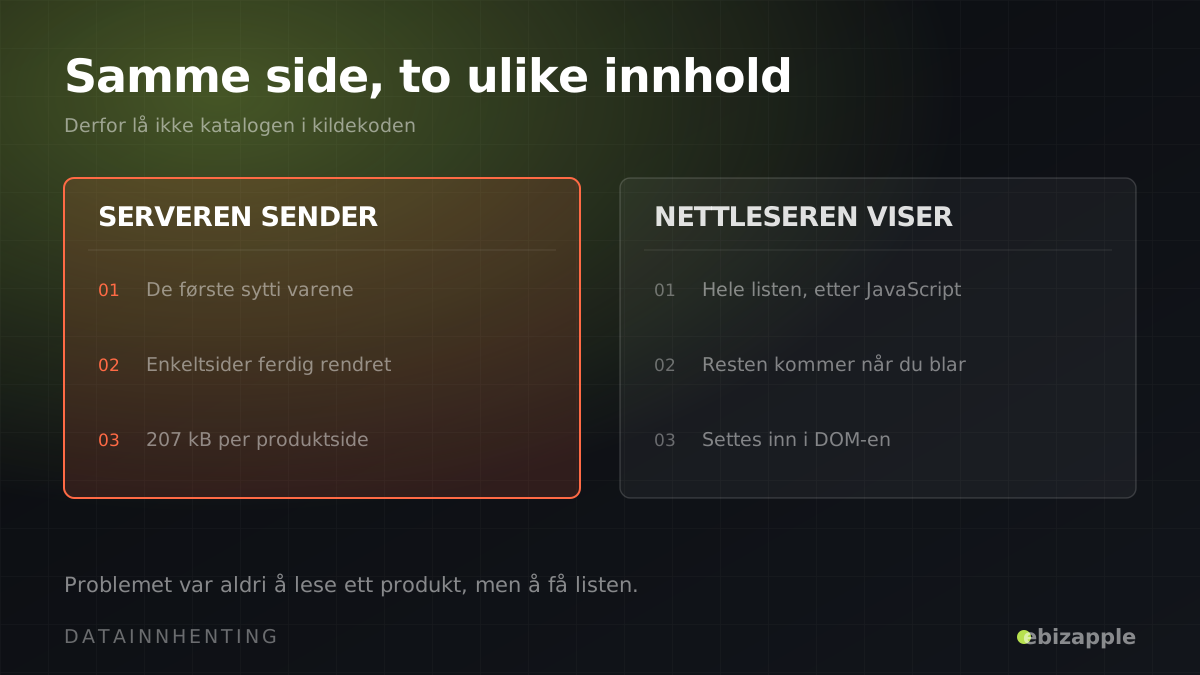
Den viktige forskjellen: serveren rendrer bare den første skjermfullen. Det er server-side rendering av toppen av listen; resten hentes med lazy-loading etter hvert som brukeren blar, og settes inn i DOM-en av nettleseren underveis. Åpner du kildekoden på en oversiktsside, finner du ikke katalogen. Du finner de første sytti varene.
Den forskjellen er verdt å holde fast ved, for den forvirrer mange: det du ser i utviklerverktøyet, er DOM-en etter at JavaScript har kjørt — ikke HTML-en serveren sendte. Et menneske ser de samme produktene i begge tilfeller. En maskin som bare henter adressen, ser bare det første.
Enkeltproduktsidene var derimot fullt server-rendret. Åpnet vi /produkter/{id}, lå alt der: navn, pris, antall, status, i strukturert form. Rundt 207 kilobyte per side.
Så problemet var aldri å lese ett produkt. Problemet var å få tak i listen over alle produktene.
Den billigste hypotesen først. Kanskje hele katalogen ligger i HTML-en, bare skjult med CSS?
Vi hentet siden og telte forekomster av prisfeltet.
Sytti treff. Ikke ett mer, uansett hvilken oversiktsside vi hentet.
Falsifisert. Serveren sender virkelig bare sytti varer, resten kommer ved scroll.
Verdien av dette steget var ikke svaret. Det var at det kostet fem minutter å utelukke den letteste veien.
Neste hypotese: de fleste moderne nettsteder har et REST-API liggende bak kulissene, gjerne udokumentert. Finner du det, er jobben nesten over — et REST-API svarer med JSON, altså ferdig strukturerte felter, mens HTML er de samme dataene pakket inn i noe du må grave dem ut av igjen.
Vi prøvde de vanlige stiene. /api/produkter, /api/products, /api/v1/, og et par varianter til.
Ingenting. Her er HTTP-statuskoden hele svaret, og de tre du bør kunne skille mellom er disse:
Vi fikk 404 på samtlige. Ikke en låst dør, bare ingen dør.
Falsifisert — og skillet er verdt å ta med videre. En 401 er ikke en invitasjon til å prøve nøkler. Den er beskjed om at det finnes noe her du må spørre om tilgang til.
Skal du selv levere data ut av eget system, er dette veien du bør bygge: et dokumentert REST-API med JSON, i stedet for at noen må lese seg til tallene fra HTML-en din. Det er den samme datakilden vi setter opp bak dynamiske nettsider når katalogen skal kunne brukes flere steder enn på én side.
Her ble det interessant. Nettstedet brukte Supabase, og Supabase-prosjektets adresse lå åpent i kildekoden. Supabase har et REST-API som er tilgjengelig utenfra hvis nøkler og rettigheter er satt slakt.
Vi sjekket hva som faktisk lå eksponert.
Svaret: kun bildeadressene. Datatabellene var beskyttet slik de skal være. Ingen nøkkel lå ute som ga tilgang til produktdata.
Falsifisert — og det er verdt å si tydelig: hadde den ligget åpen, ville vi ikke brukt den. En feilkonfigurert database er ikke en datakanal. Det er en sårbarhet, og å høste fra den er en helt annen handling enn å lese en offentlig side. Grensen går ved autentisering, ikke ved om det er teknisk mulig.
Det er den samme grensen vi holder når vi kobler på betaling og andre systemer som håndterer verdier — se gjennomgangen av betalingsløsninger for nettbutikk. Rekkefølgen derfra gjelder også utenfor kassen: nøklene til et REST-API finnes ikke før avtalen er signert, og en nøkkel som likevel ligger ute, er en glipp — ikke en tillatelse. Vi har beskrevet den samme rekkefølgen for kort, PayPal og Stripe i WooCommerce.
Vi fant strengen cursor i sidekoden. Markørbasert paginering er den vanlige måten å bla gjennom store datasett, så dette så lovende ut.
Vi brukte en time på å finne ut hvordan markøren skulle sendes.
Det var CSS-klassen cursor-pointer. Musepekeren.
Falsifisert, og litt flaut. Men det illustrerer noe reelt: når man leter etter et mønster, ser man mønsteret overalt. Skriv ned hypotesen før du tester den, ellers begynner du å tolke støy som signal.
Det illustrerer også hvorfor en CSS-klasse aldri er et pålitelig holdepunkt for datahenting. En CSS-klasse sier hvordan noe skal se ut, ikke hva det betyr, og navnene byttes ut hver gang designet endres. Vi holder derfor presentasjon og datalag strengt atskilt når vi bygger selv — det er kjernen i å ta komponenter før sider.
Next.js App Router bruker en mekanisme som heter React Server Components. Den forhåndshenter sider i bakgrunnen med en parameter i adressen: ?_rsc=.
Hypotesen: kanskje den forespørselen returnerer en liste, ikke bare én side?
Her stoppet vi opp. Vi klarte ikke å fremkalle forespørselen selv — nettstedet blokkerte den headless nettleseren vår. En headless nettleser er en helt ekte nettleser uten vindu, styrt av kode: den kjører JavaScript og bygger DOM-en akkurat som nettleseren på maskinen din. Den lar seg bare kjenne igjen på små detaljer i hvordan den melder seg, og stadig flere nettsteder ser etter nettopp de detaljene.
Det er også grunnen til at vi ikke lover en dekningsgrad på forhånd når jobben avhenger av et nettsted vi ikke kontrollerer. Det er samme resonnement som ligger bak at vi ikke gir ytelsesgaranti: et løfte om noe en tredjepart bestemmer, er ikke et løfte, det er en gjetning med selvtillit.
Så gjorde kunden det vi ikke kunne. Han åpnet nettverksfanen i sin egen nettleser, blad på siden, og limte inn den forespørselen som faktisk gikk ut.
GET https://[nettstedet]/produkter/cmq0rxvv4000wj70bvnhiiod4?_rsc=12sgb
Det avgjorde saken. Adressen inneholder én produkt-ID. Det er forhåndshenting av én side, ikke et listeuttrekk.
Falsifisert — og med det var alle billige veier utelukket.
Den brikken er verdt å merke seg for seg selv: da automatikken var stengt ute, la mennesket brikken på ett minutt. Vi bruker det som arbeidsdeling nå. Maskinen tar volumet, mennesket tar det maskinen fysisk ikke kommer til.
Står dere fast på samme sted? Fire blindveier er ikke et nederlag, det er en kartlegging. Send oss adressen, så sier vi hvilken vei som er åpen — og hva den koster.
Én vei gjensto som ikke krevde tung maskineri: sitemap.xml.
Vi fant den der de fleste ligger — oppført nederst i robots.txt, som er det første stedet man skal se etter den. En sitemap er nettstedets egen adresseliste, laget for søkemotorer, og den er offentlig med vilje.
Den ga oss ekte produktadresser, og hver adresse ga en side vi kunne lese fullt ut. Vi bygde en jobb som gikk gjennom listen og hentet varedata fra hver side — samme type automatisering som vi setter opp for overvåking og datainnhenting ellers.
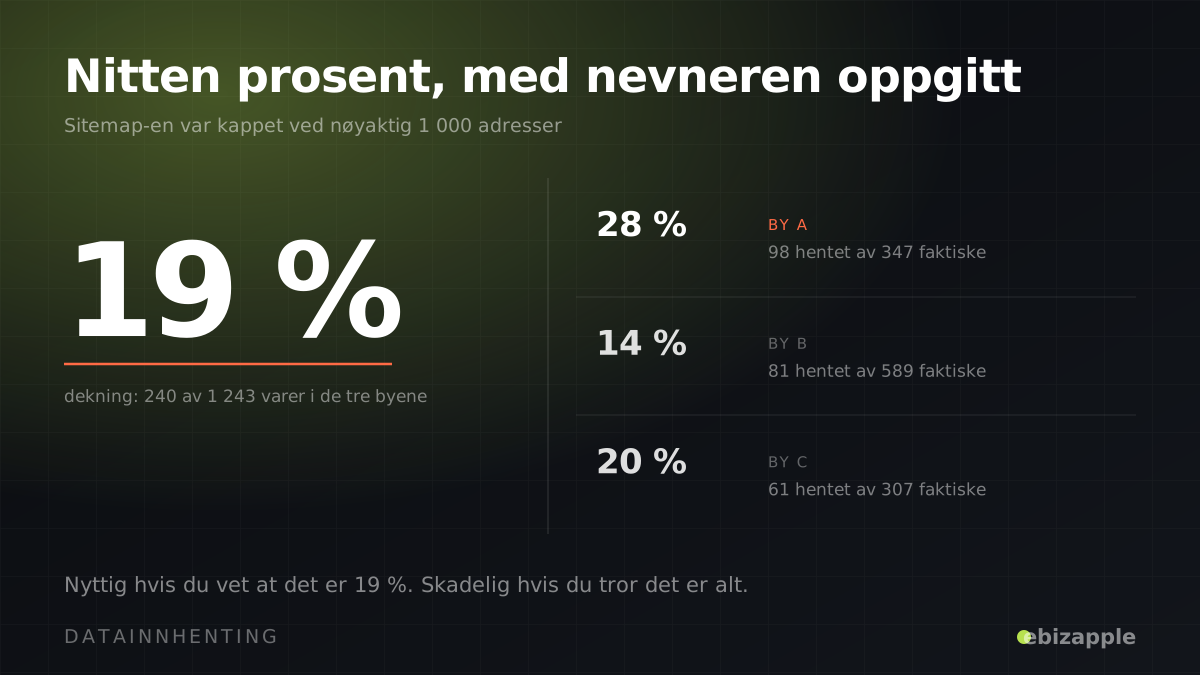
Men sitemap-en var kappet ved nøyaktig 1 000 adresser, og skjevt vektet mot de nyeste varene.
For de tre byene kunden brydde seg om ble dekningen slik:
Nitten prosent.
Vi kunne rundet oppover, kalt det «et representativt utvalg» og latt være å nevne nevneren. Det er fristende når man har brukt en uke.
Vi skrev nitten prosent i rapporten, med tabellen over.
Grunnen er enkel: kunden skulle ta beslutninger på tallene. Et prisbilde bygget på nitten prosent av sortimentet er nyttig hvis du vet at det er nitten prosent. Det er direkte skadelig hvis du tror det er alt.
Og nitten prosent var uansett nok til å vise verdi fra dag én — skjevheten mot nyeste varer betydde at vi fanget nettopp det som endret seg.
Ekte tall fra kjøringen, fordi ingen publiserer dem:
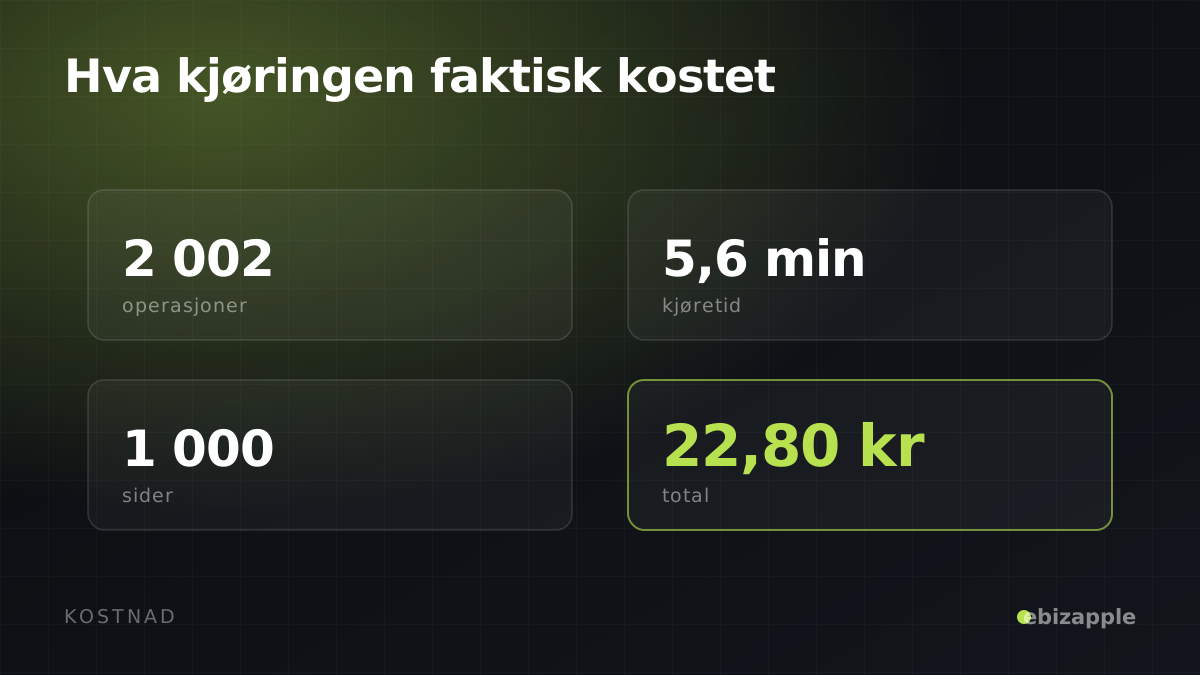
| Operasjoner | 2 002 |
| Kjøretid | 5,6 minutter |
| Kostnad, engangskjøring | ca. 22,80 kr |
| Sider hentet | 1 000 |
Det gjør en fullstendig katalog-gjennomgang til rundt tjuetre kroner. Den daglige overvåkingen som kjører videre, koster brøkdelen — den ser bare på det som er nytt.
Det er verdt å ha i bakhodet neste gang noen sier at automatisering er dyrt. Utviklingen koster. Kjøringen koster nesten ingenting.
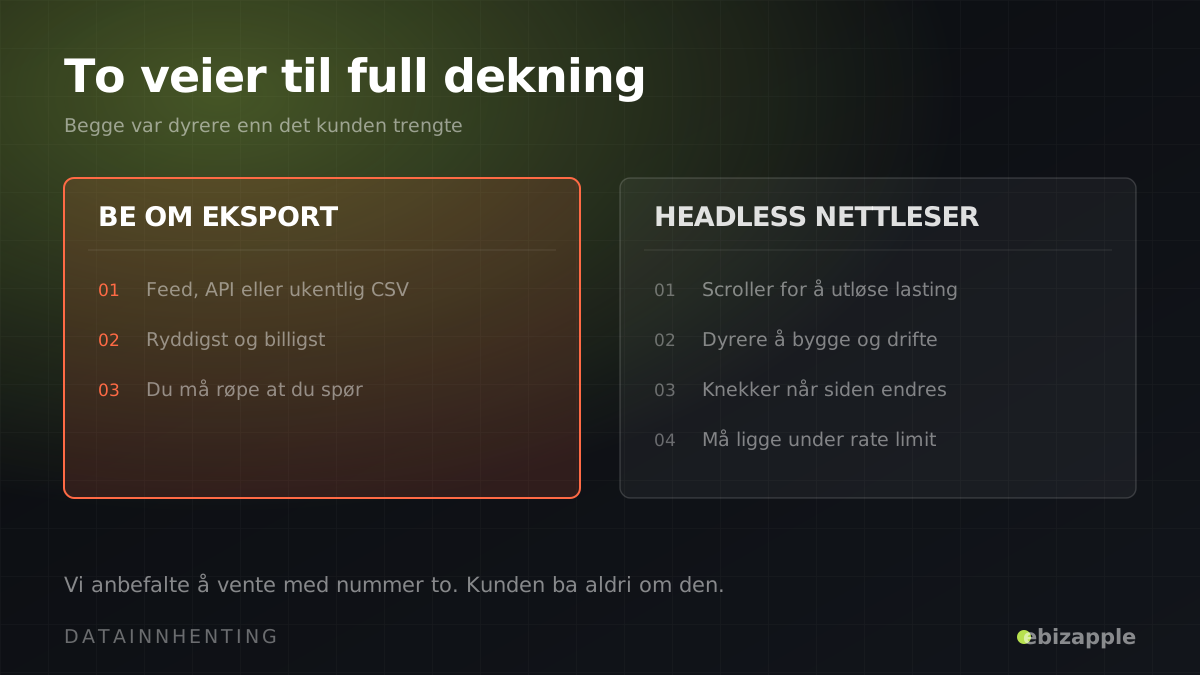
Full dekning var fortsatt mulig. Begge veiene dit var bare dyrere enn det kunden trengte:
Be nettstedet om en eksport. En feed, et REST-API eller for den saks skyld en CSV-fil per uke. Ryddigst, billigst, og det tåler å bli kjent. Ulempen er at man må røpe at man spør.
Kjøre en headless nettleser som blar. Teknisk fullt mulig: den laster siden, utløser lazy-loadingen ved å scrolle, og leser produktene ut av DOM-en etterpå. Betydelig dyrere å bygge, dyrere å drifte, og skjørere — nettstedet endrer seg, og da knekker det. I tillegg må jobben legge seg under nettstedets rate limiting, ellers stanser den seg selv midtveis.
Vi anbefalte å ikke bygge nummer to før kunden faktisk ba om full dekning. Det gjorde han ikke. Nitten prosent løste problemet han hadde.
Det er kanskje den mest nyttige lærdommen i hele prosjektet: den dyre løsningen var ikke nødvendig, og vi fant det ut ved å levere den billige først.
Og uansett hvilken vei dataene kommer inn, skal de som regel ut igjen et sted: i en oversikt, et filter eller en prisliste kunden faktisk ser på. Det er da datainnhentingen møter en dynamisk nettside med en datakilde bak — henting og visning er to jobber, og de bør ikke blandes sammen i samme skript.
Om du står foran samme problem:
cursor-pointer til paginering.Ikke alltid. Under står vår faktiske beslutningsregel — den vi bruker før vi sier ja til et slikt oppdrag. Flere av radene ender i «nei», og de er med nettopp derfor.
| Situasjon | Vi ville | Hvorfor |
|---|---|---|
| Leverandøren tilbyr en feed eller et REST-API | Ta feeden | Ferdig JSON slår enhver utgraving fra HTML. Billigere å bygge, tåler dagslys, og knekker ikke når designet endres. Bruk heller tiden på koblingen mellom systemene. |
| Du trenger bare et prisbilde, ikke fasit | Hent selv — start med sitemap.xml |
Vår kjøring kostet 22,80 kr og ga 19 % dekning. Det var nok til beslutningen kunden faktisk skulle ta. |
| Du trenger full dekning, og tallet skal inn i et system | Spør om en eksport først | Full dekning fra utsiden krever headless nettleser, drift og vedlikehold. Be om feed før du betaler for det. |
| Dataene ligger bak innlogging | Ikke gjør det | Grensen går ved autentisering. Har du ikke fått tilgang, er det ingen datakanal — og brukervilkårene du godtok ved registrering, gjelder deg spesielt. |
| Brukervilkårene forbyr automatisert innhenting | Ikke gjør det — spør om en feed i stedet | Vilkår er ikke straffelov, men de er en avtale, og motparten har et sivilrettslig krav. En e-post er billigere enn en tvist. |
| Du treffer 401, 403 eller rate limiting | Stopp og spør | Alle tre er beskjeder, ikke tekniske hindringer å komme rundt. Å omgå dem er en annen handling enn å lese en åpen side. |
| Dataene inneholder navn eller kontaktinfo | Stopp og vurder jussen | Da gjelder personopplysningsloven, uansett hvor åpent det ligger. Produktdata er noe helt annet enn persondata. |
| Sidene er server-rendret, uten lazy-loading | Hent selv | Da ligger alt i HTML-en fra første byte. Dette er den billige varianten, og den er ofte gjort på en dag. |
| Du har ikke budsjett til headless drift | Lever den billige veien først | Sitemap og enkeltsider koster nesten ingenting å kjøre. Se hva 19 % gir før du bygger for 100 %. |
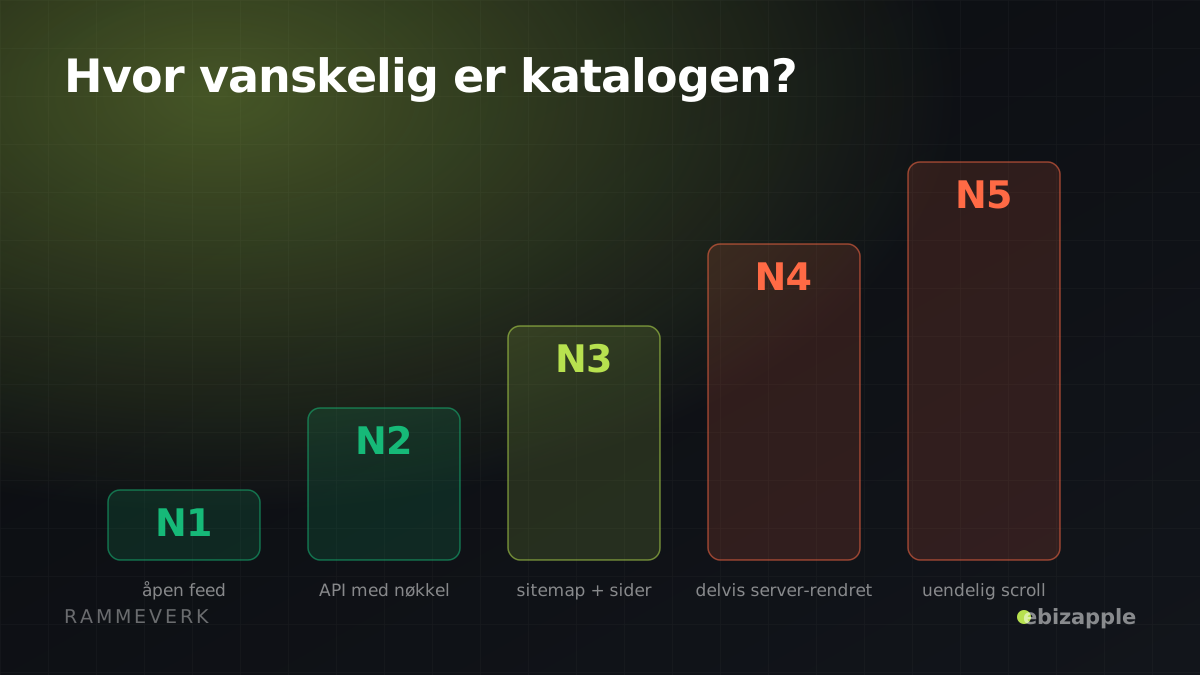
| Du vet ikke hvilken av radene som gjelder deg | Få nettstedet vurdert | En kartlegging tar timer, ikke uker — send oss adressen, eller anslå selv med nivåskalaen N1–N5. |
Legg merke til at «spør om en feed» går igjen. Det er ikke beskjedenhet. Det er at en avtalt datakanal er den eneste varianten som fortsatt virker om et år, uansett hvor flink man er til å hente selv.
Erfaringene fra dette og lignende prosjekter er samlet i en skala fra N1 til N5 — fra åpen feed til uendelig scroll uten noe API i det hele tatt. Den lar deg anslå tid og kostnad før du begynner å bygge.
Skalaen er gjennomgått i egen artikkel: nivågradering av kataloger, N1 til N5.
Hele prosjektet, i de fire tallene som faktisk ble målt:
Produktdata er ikke persondata, så personopplysningsloven gjelder ikke. Tre andre ting avgjør: nettstedets bruksvilkår, databasevernet i åndsverkloven, og hvor hardt du belaster serveren. Det ryddigste er å spørre om en offisiell datakanal først.
I vårt prosjekt kostet en fullstendig gjennomgang av 1 000 sider ca. 22,80 kroner — 2 002 operasjoner på 5,6 minutter. Kjøringen er nesten gratis; det er utviklingen som koster.
Moderne rammeverk som Next.js server-rendrer bare den første skjermfullen. På nettstedet vi kartla lå det sytti varer i HTML-en, uansett hvilken oversiktsside vi hentet. Resten kommer med lazy-loading når brukeren blar, og legges inn i DOM-en av nettleseren. Derfor ser du alt i utviklerverktøyet og bare sytti i kildekoden.
En sitemap er nettstedets egen liste over adresser, laget for søkemotorer, og den står som regel oppført i robots.txt. Den er ofte den enkleste veien inn — men den kan være kappet. Vår var kuttet ved nøyaktig 1 000 adresser og skjevt vektet mot de nyeste varene, som ga 19 % dekning av sortimentet.
Det kommer an på hva tallet skal brukes til. Nitten prosent er nyttig hvis du vet at det er nitten prosent, og skadelig hvis du tror det er alt. I dette tilfellet holdt det, fordi skjevheten mot nyeste varer traff nettopp det som endret seg.
Jo, teknisk er det fullt mulig og gir full dekning. Det er bare betydelig dyrere å bygge, dyrere å drifte og skjørere — endrer nettstedet seg, knekker det. Vi anbefaler å levere den billige løsningen først og se om den holder.
Trenger dere data ut av et nettsted, eller inn i deres eget? Vi tar gjerne en prat om hva som lar seg gjøre — og hva som ikke gjør det. Ta kontakt, eller les om dynamiske nettsider og automatisering.
Avis-ID-en skifter hver uke. Det er den ene detaljen som avgjør om automatiseringen lever eller dør på mandag.
Det vanligste spørsmålet vi får om datainnhenting — web scraping, som det heter på engelsk — er «hva koster det?».
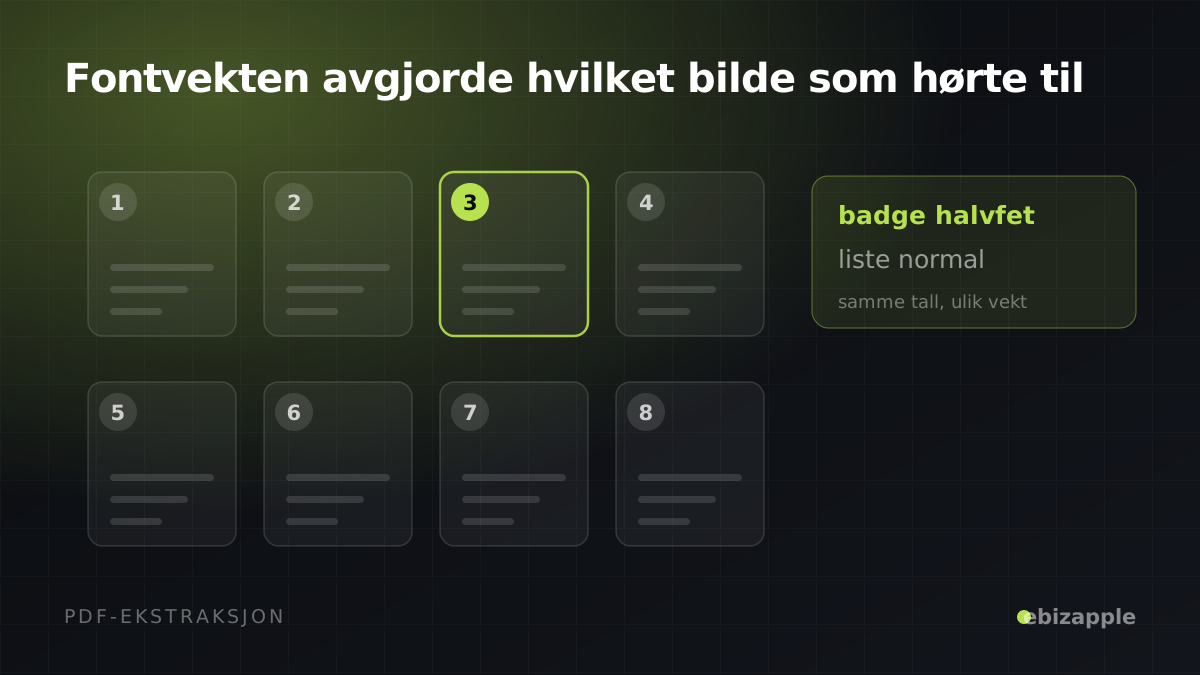
En PDF-katalog på tolv megabyte inn, nittitre produkter ut. Bildene koblet vi på til slutt — og løsningen lå i fontvekten, ikke i posisjonen.
Denne artikkelen hører til datainnhenting. Skal noen gjøre jobben for deg, er det dette vi tilbyr: hjelp til å hente ut data.